테크/AI모비인사이드
개발자 0명 팀이 업무 자동화 32개를 굴린다 — 버즈빌 BDSO팀이 개인기를 팀 시스템으로 바꾼 순서
개발자가 한 명도 없는 버즈빌 BDSO팀이 업무 자동화 32개를 운영합니다. 매출 하락 1차 분석 7분, 조작 90% 감소를 만든 비개발자 AI 업무 자동화와 시스템화 순서를 정리했습니다.
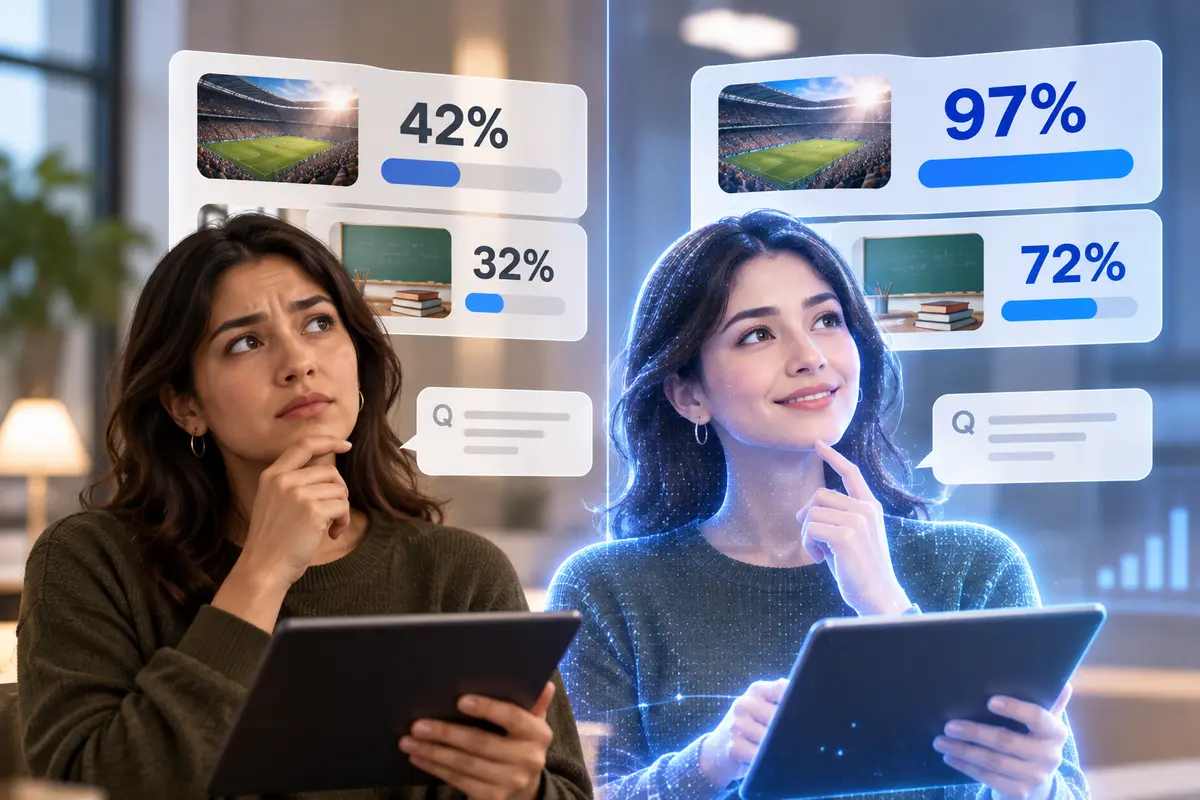
상세페이지 시안 세 개를 놓고 고객 조사를 하면 몇 주가 걸리지만, AI에게 “30대 직장인 여성 30명이 돼서 골라 줘”라고 하면 10분이면 끝납니다. 이런 AI 합성 응답자(가상 고객) 설문이 빠르게 퍼지고 있습니다. 그런데 미국 여론조사 기관 퓨리서치(Pew Research Center)가 9월 30일 공개한 실험은 이 숫자를 그대로 믿으면 안 된다고 말합니다.
이유는 시간과 비용입니다.
학계 결과도 기대를 키웠습니다. 스탠퍼드 팀이 1,052명을 두 시간씩 인터뷰해 만든 AI 분신은 사회조사 질문에서 본인 재응답 일관성 대비 82~86% 정확도를 보였고, 올해 네이처에 실린 연구는 실험 70개의 메시지 효과 방향을 상관계수 0.85로 맞혔습니다.
퓨는 상설 패널 ‘아메리칸 트렌드 패널’ 응답자 한 명마다 AI ‘디지털 트윈’을 만들었습니다. 1월·3월·4월 조사 세 건을 각각 8,512명, 3,507명, 5,103명 규모로 복제해 300문항 가까이 돌렸습니다. 예선에서 오차가 가장 작았던 클로드 오퍼스 4.6을 본선에 썼습니다.
세 조사 평균 오차는 12.4%p였고, 전체 문항의 28%가 15%p를 넘게 틀렸습니다. 전국 여론조사의 오차 범위가 보통 ±3%p 안팎이니 그 네 배입니다.
사람은 ‘잘 모르겠다’를 16% 골랐지만 AI는 4%였습니다. 수정헌법 1조 상식 문제는 사람 52%, AI 98%가 맞혔습니다. 평범한 사람의 모름을 흉내 내지 못합니다.
마케터에게 가장 중요한 대목입니다. 미국 히스패닉 성인 중 다음 월드컵을 볼 것 같다는 사람은 42%인데 AI는 97%였습니다. 집단별 오차는 소수 집단일수록, 성향이 뚜렷한 집단일수록 컸습니다. AI는 개인이 아니라 그 집단의 고정관념으로 답합니다.
모델의 지식 기준일 이후 일에서 크게 틀렸습니다. 전기요금이 매우 걱정된다는 사람은 52%인데 AI는 23%로, 가장 큰 29%p 차이가 났습니다.
같은 프로필로 GPT-5.1은 극단적인 의견을, 오퍼스는 온건한 의견을 냈습니다. 어떤 AI를 쓰느냐에 따라 ‘소비자 의견’이 달라집니다.
틀린 데이터도 표와 그래프는 멀쩡하게 나옵니다. 퓨의 결론은 “AI 모델은 전통적 여론조사의 적절한 대체물이 아니다”였습니다. 다만 주관식 답변 분류와 데이터 분석에는 쓰라고 했습니다.
소재 성과를 사전에 예측하는 다른 접근은 크로거, 광고 집행 전에 전환을 81% 정확도로 예측했다에서, AI가 마케팅 직무에 미치는 영향은 가트너 “2030년엔 AI로 신입 마케터 자리를 없앨 수 있다”에서 볼 수 있습니다.
퓨리서치가 사람 패널을 AI로 복제해 300문항 가까이 돌린 결과 평균 오차는 12.4%p였고, 전체 문항의 28%는 15%p 넘게 틀렸습니다. 일반 여론조사 오차 범위(±3%p 안팎)의 약 네 배입니다.
AI는 개인이 아니라 그 집단에 대한 고정관념으로 답하는 경향이 있어, 다수 의견을 전원 의견처럼 만듭니다. ‘잘 모르겠다’도 거의 고르지 않아 응답 분포가 좁아집니다.
시안·콘셉트 비교로 후보를 줄이거나, 질문지를 점검하고 가설을 세우는 데는 쓸 수 있습니다. 구매 의향 비율, 최근 이슈 반응, 출시·가격 결정처럼 숫자와 예측이 필요한 판단은 실제 고객 조사로 해야 합니다.
기사에서 본 내용을 우리 사이트에 대입해 보고 싶다면, 무료 진단으로 현재 상태부터 확인해 보세요.
영업일 기준 24시간 안에 담당자가 직접 답변드립니다.
개발자가 한 명도 없는 버즈빌 BDSO팀이 업무 자동화 32개를 운영합니다. 매출 하락 1차 분석 7분, 조작 90% 감소를 만든 비개발자 AI 업무 자동화와 시스템화 순서를 정리했습니다.
메타가 AI 에이전트 뮤즈의 상위 모델 ‘뮤즈 원더’와 ‘뮤즈 원더 풀’을 내놨습니다. 액티브 메모리·액티브 포커스로 며칠짜리 작업까지 맡지만, 판매 위임 중 주소가 노출된 사례처럼 위험도 남아 있습니다.
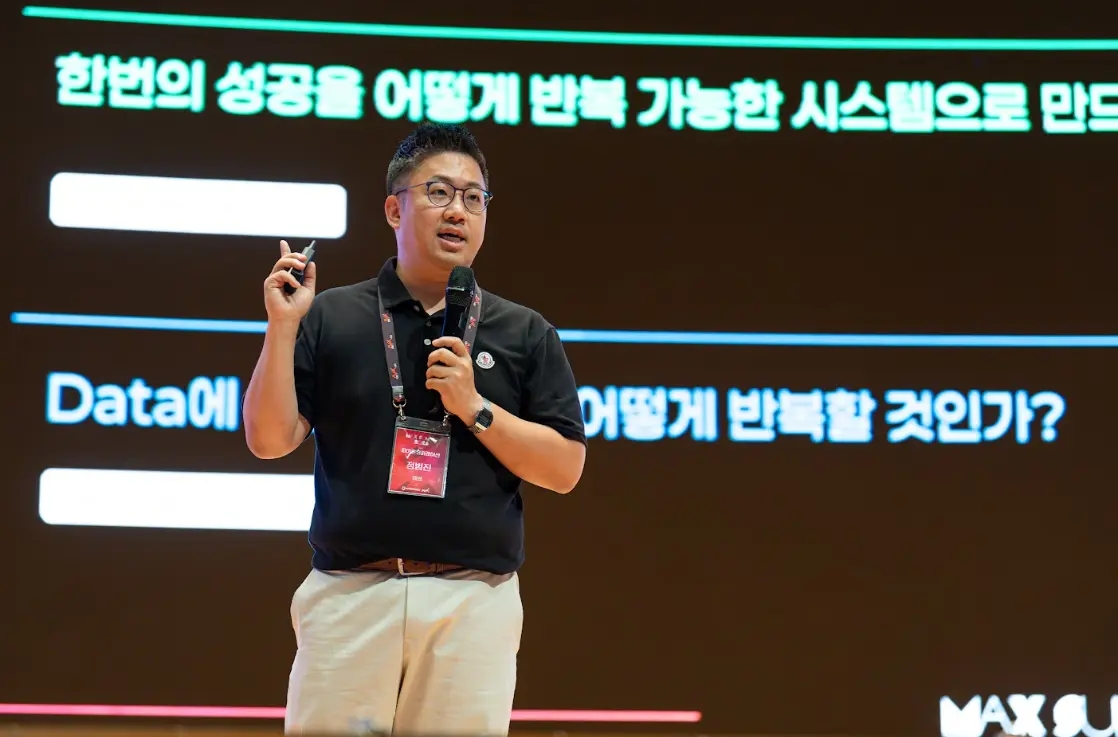
AI로 콘텐츠를 많이 만들수록 브랜드는 덜 보이는 역설이 생겼습니다. 정범진 파이온코퍼레이션 대표가 AI 슬롭 시대에 마케팅 AX를 운영 시스템으로 설계해야 하는 이유와 사례를 말했습니다.